
Table of Contents
Great systems are not just built. They are monitored.
MetricFire runs Graphite and Grafana as a fully managed service for growing engineering teams, taking care of storage, scaling, and version updates so your team doesn't have to. Plans start at $19/month, billed per metric namespace rather than per host, and include engineer-staffed support. Integrations work natively with Heroku, AWS, Azure, and GCP, and data is stored with 3× redundancy in SOC2- and ISO:27001-certified data centres.
優れたシステムは、構築するだけでは不十分です。適切に監視することが重要です。MetricFireは、成長するエンジニアリングチーム向けに、GraphiteとGrafanaをフルマネージドサービスとして提供しています。ストレージ、スケーリング、バージョンアップなどをMetricFire側で管理するため、チームは監視環境の運用負荷を抑えながら利用できます。
はじめに
これまでのシリーズでは、Graphiteでよりサービス指向のアラートを実現するためのさまざまな考え方を紹介してきました。具体的には、メトリクスの命名規則、ワイルドカードを利用したグルーピング、AND / OR条件を利用した複合アラートなどについて解説しました。それぞれ異なる問題を扱っていますが、最終的な目的は共通しています。アラートノイズを減らし、障害発生時の状況をより明確に把握できるようにすることです。
今回は、これまで紹介してきた考え方を、実際のMetricFireのインフラ環境に適用した事例を紹介します。実は私たち自身も、これまでのシリーズで紹介してきたものと似たアラート運用上の問題を抱えていました。そこで、これらの考え方を自社のインフラに適用し、障害発生時に生成されるノイズの多い重複アラートを減らすことにしました。
MetricFireでは、メトリクスの取り込み処理を担うインフラの一つに、私たちが「cops layer」と呼んでいるルーティング層があります。このサーバー群はメトリクスの取り込みパイプラインの中間に位置し、システム内のさまざまな場所へのメトリクストラフィックの転送、リプレイ、ルーティングを担当しています。当然ながら、このような本番環境のインフラでは、多数のメトリクスや内部サービスが存在します。そのため、何か問題が発生すると、実際には同じ根本原因による障害であるにもかかわらず、複数のアラートが同時に発生することがあります。
この記事では、複数の内部アラートをComposite Alert(複合アラート)を使って1つのサービスレベルアラートにまとめた方法を紹介します。その結果、アラート数が減少し、障害の状況がより明確になり、オンコール対応時に本当に必要な情報を把握しやすくなりました。
1. メトリクス単位のインフラアラートが抱える問題
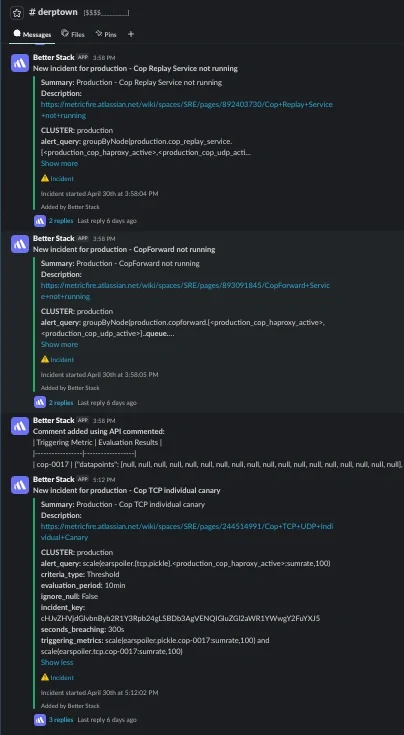
今回の問題は比較的シンプルでした。copsサーバーが停止すると、複数の独立したアラートが同時に発生していたのです。それぞれのアラートは異なるメトリクスや内部コンポーネントを監視していました。しかし、運用上はすべて同じ障害状態を示していました。例えば、1台のホストが停止すると、以下のようなアラートが発生する可能性があります。
- forwarder queue processing
- replay queue processing
- dropped TCP/UDP canary datapoints
これらのアラートは、技術的にはすべて正しいものでした。しかし、実際には同じ根本原因を示しており、SlackやPagerDutyに不要な通知が大量に発生していました。つまり、問題はメトリクスが不正確だったことではありません。問題だったのは、アラートが個々のメトリクスに紐づいており、サービス全体の状態を表していなかったことです。
複数のアラート、1つの根本原因
MetricFireのcops layerは、トラフィックのルーティング処理におけるそれぞれ異なる役割を担う複数の内部コンポーネントで構成されています。
主要なサービスの一つがcopforwardです。これはメトリクスを集約先へ転送する役割を担っています。もう一つがreplayサービスです。こちらは、下流の送信先が利用できなくなった際に発生するスピルオーバーしたメトリクスを処理します。
内部的には、replayサービスは、転送に失敗した際にcopサービスによって書き込まれるspoolファイルを追跡しています。これらのspoolファイルは非同期で処理され、送信先が再び利用可能になるとリプレイされます。また、replayサービス自体がcopforwardをベースとして構築されているため、一部の運用メトリクスが重複しており、似た方法で監視することができます。
その結果、copホストが完全に停止すると、多くのメトリクスに変化が発生します。例えば、Canaryメトリクスが停止する、forward queueのメトリクスが消える、replay queueのメトリクスが消える、トラフィックがルーティング層を正常に通過できなくなり、ドロップしたデータポイントが増加するといった現象が発生します。それぞれのアラートは、監視対象となる個々のメトリクスの状態を正確に反映しています。しかし運用上は、すべて同じ問題、つまり「ホストが停止している」ことを示していました。
2. 問題を「サービス」として捉え直す
この問題を解決する上で、大きな転換点となったのが、「個々のメトリクス」ではなく「サービスの状態」という視点で問題を捉えることでした。それまで私たちは、
「どのメトリクスに対してアラートを設定すべきか?」
と考えていました。しかし、そこから、
「copsサービスの健全性を最も適切に表すシグナルは何か?」
と考えるようにしました。この違いによって、アラートの設計方法そのものが変わりました。cops layer自体をサービスの境界として考え、その内部にあるメトリクスを、そのサービスのさまざまな状態を表す「シグナル」として捉えます。今回のアラート変更では、重要なシグナルを以下の4つにしました。
- ホストの稼働状況
- Forwarding queueのアクティビティ
- Replay queueのアクティビティ
- ドロップしたデータポイント
それぞれが同じシステム内で発生する異なる障害パターンを表しています。これは、これまでの記事で紹介してきた「サービスとシグナル」という考え方にも一致しています。目的は、個々のメトリクスに対して独立したアラートを発生させることではありません。copsサービス全体の状態を表す1つのアラートを定義することです。
Composite Alertの定義
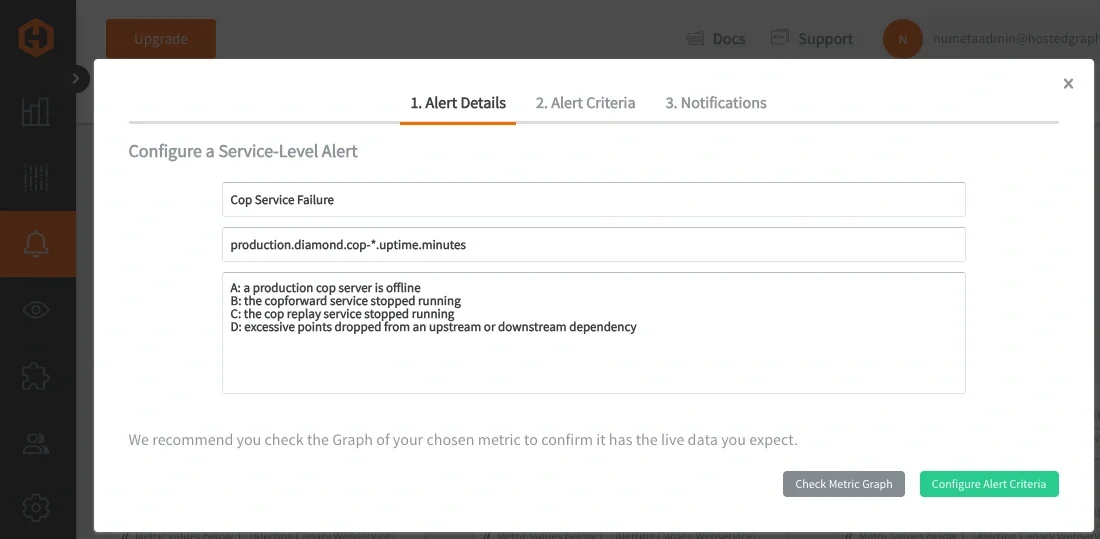
MetricFire自身のComposite Alerting機能を利用し、以下の4つの条件を組み合わせて、1つのサービスレベルアラートを設定しました。
IF production.diamond.cop-*.uptime.minutes is missing FOR 10min

OR groupByNode(production.copforward.cop-*.*.queue.*, 2) is missing FOR 10min

OR groupByNode(production.cop_replay_service.cop-*.*.queue.*, 2) is missing FOR 10min

OR production.cop-*.cop-*.datapoints.dropped_destination_full:sum is above 2500 EVER
アラートの説明には、それぞれの条件が何を意味しているのかをシンプルに記載しました。4つの条件は、それぞれ同じサービス内の異なるシグナルを表しています。
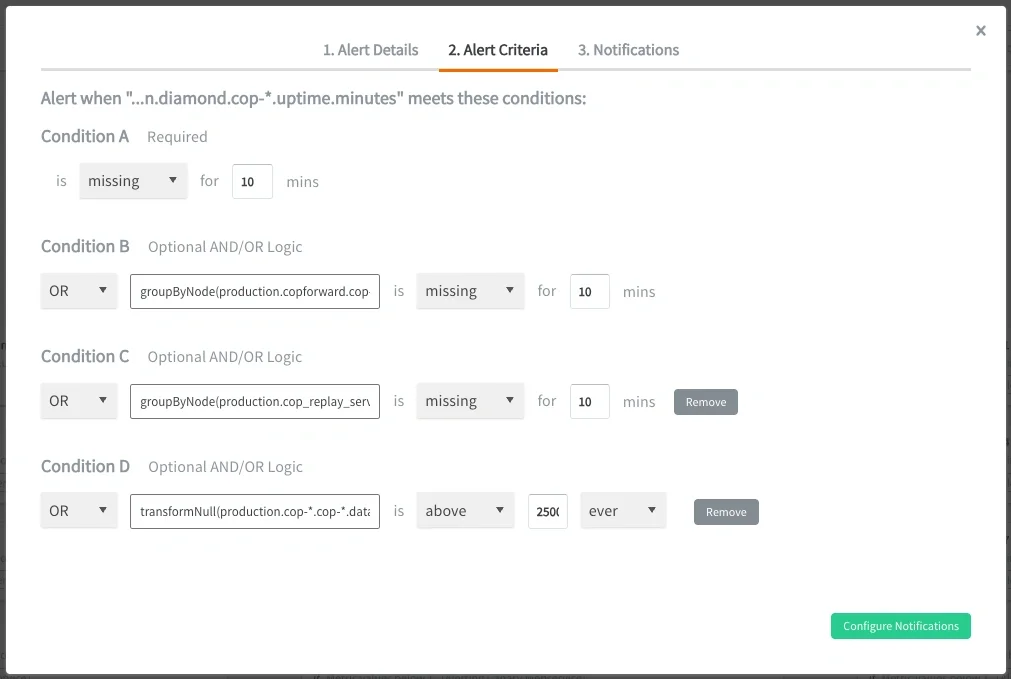
そのため、コンポーネントごとに個別のアラートを発生させるのではなく、トラフィックルーティング層そのものの健全性を表す1つのアラートとして扱えるようになりました。なお、これらのアラートクエリでは、ワイルドカードによるグルーピングを使用して、すべてのcopサーバーを対象にしています。また、GraphiteのgroupByNode()などの関数を利用して、グループ化したメトリクスをさらに集約しています。
3. 複数のアラートから1つのサービスレベルアラートへ
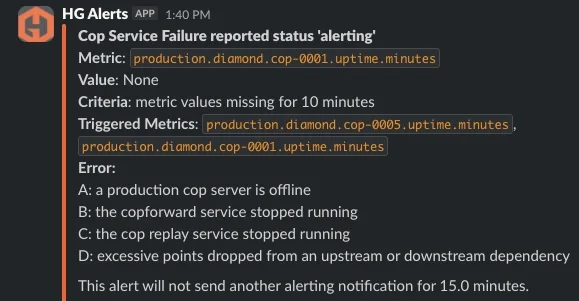
Composite Alertを導入すると、運用方法はすぐに変わりました。以前は、copの障害が発生すると複数の独立したアラートが生成され、それらが同じ障害に関連しているのかをエンジニアが手動で判断する必要がありました。アラートをサービス境界に基づいて再構成したことで、同じ障害が発生しても、関連するシグナルを含んだ1つのアラートだけが発生するようになりました。これにより、障害発生時のノイズが大幅に減り、プレッシャーのかかる状況でもアラートを解釈しやすくなりました。
- Forwarding alert
- Replay alert
- Dropped canary datapoints alert
以前は、オンコール担当のエンジニアがこれら複数のアラートを確認する必要がありました。現在は、
- 1つのcop service alert
- トリガーとなったシグナルの一覧
を確認すればよくなりました。ここで、これまでの記事で紹介してきた考え方が一つにつながります。アラートはサービスを表し、その原因となったメトリクスが「なぜアラートが発生したのか」を説明するのです。
なぜ「問題を起こしたメトリクス」が重要なのか
Composite Alertのロジックそのものと同じくらい重要だったのが、問題を起こしたメトリクス(Offending Metrics / Triggered Metrics)の一覧を返すことでした。以前は、ワイルドカードを使用したアラートクエリを実行すると、アラートを発生させた具体的なメトリクスではなく、グループ化されたワイルドカード式そのものが返されていました。そのため、障害発生時には、エンジニアがさらに「どのホストで、どのシグナルに問題が発生したのか」を手動で特定する必要がありました。Offending Metricsを有効にすると、実際に条件を超えたシグナルだけがアラートに表示されます。
これによって、障害対応時のフィードバックループが大幅に短くなります。エンジニアはすぐに、
- どのホストに問題があるのか
- どのシグナルがアラートを発生させたのか
- サービスのどの部分が劣化しているのか
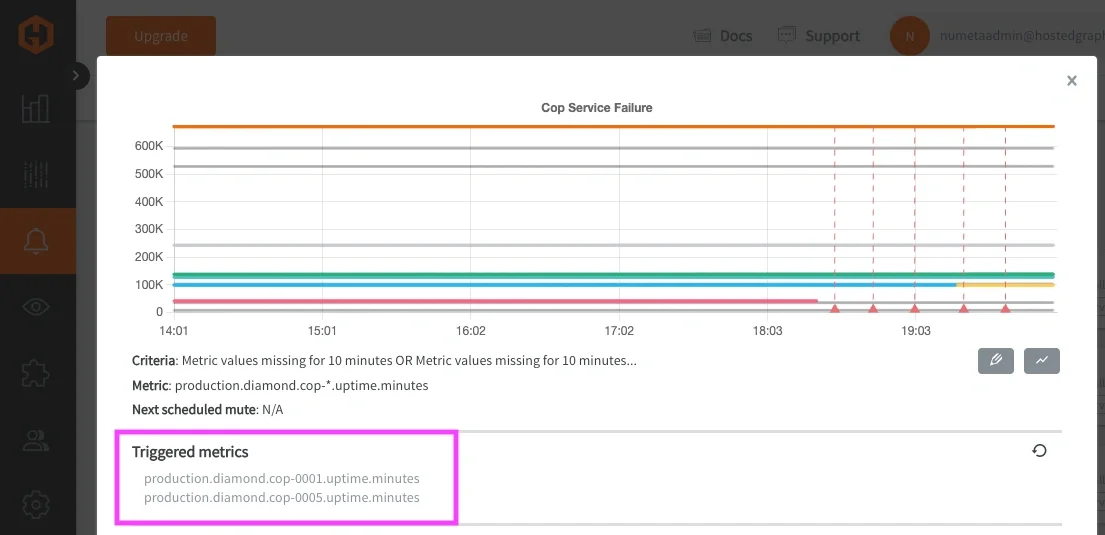
その結果、オンコール対応時に必要だった手動での関連付け作業が減り、copsのアラートをより実用的なものにすることができました。
4. 運用への影響
今回の変更によって、システムからアラートそのものがなくなったわけではありません。そして、それが目的だったわけでもありません。目的は、個々のメトリクスの変化ではなく、意味のある運用上の状態をアラートとして表現することでした。アラートをサービスとそのシグナルを中心に再構成することで、重複した通知を削減し、障害発生時の状況を把握しやすくし、オンコール対応時の判断を容易にすることができました。
エンジニアは、複数の独立したアラートを頭の中で関連付けて、「これは実は1つのインフラ障害なのではないか?」と判断する必要がなくなりました。さらに、アラートそのものについて考える方法も変わりました。現在では、個々のメトリクスを中心にアラートルールを設計するのではなく、
- どのサービスが影響を受けているのか
- そのサービスを表すシグナルは何か
- どのシグナルの組み合わせが意味のある劣化を示すのか
という観点からアラートを設計しています。この考え方に変えることで、インフラが複雑化していっても、アラートシステムを運用しやすくなりました。もちろん、環境によって最適な方法は異なります。しかし、この考え方はSREやDevOpsチームの多くの環境に応用できます。システムが障害を起こす場合、必ずしも1つのメトリクスだけが原因になるわけではありません。むしろ、複数の関連するシグナルが同時に変化することで、システムの異常が明らかになるケースの方が多いでしょう。そのため、アラートシステムもこうした現実のシステムの挙動を反映したものにすると、より有用になります。
まとめ
今回のアラート改善シリーズは、「アラートノイズが多い」というシンプルな問題から始まりました。そこから、メトリクスの構造がグルーピングにどのような影響を与えるのか、Graphiteのワイルドカードを使ってサービス境界をどのように定義するのか、Composite Alertによって、単純な閾値超過ではなく意味のあるシステムの状態をどのようにアラートとして表現するのかについて解説してきました。
今回の事例では、これらの考え方を実際の本番環境に適用しました。MetricFireのcops layerを1つの「サービス」として捉え、その中のメトリクスを「シグナル」として扱うことで、複数の重複したアラートを、より明確な1つのサービスレベルアラートに置き換えることができました。その結果、障害発生時に必要な情報がより明確になり、より実用的なインシデント対応が可能になりました。
今回の事例から得られる重要なポイントは、アラートは、個々のメトリクスの異常を知らせるだけではなく、サービスの状態を表すものであるべきということです。
もし今回のシリーズの過去の記事をまだ読んでいない場合は、以下の記事もぜひご覧ください。
これらを組み合わせることで、Graphiteにおける、よりスケーラブルで運用しやすいアラートシステムを構築するための実践的なフレームワークを作ることができます。MetricFireを無料で試して、Graphiteの監視環境でアラートノイズを効果的に削減してみてください。